Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

Trong vài năm gần đây, công nghệ tạo hình ảnh bằng AI bùng nổ và Stable Diffusion là một trong những cái tên nổi bật nhất. Bài viết này sẽ dẫn bạn qua các khái niệm nền tảng — từ Diffusion model là gì đến cách Stable Diffusion hoạt động — rồi làm rõ sự khác biệt giữa hai chế độ Image2Image và Depth2Image, và tại sao mỗi chế độ phù hợp với những mục tiêu sáng tạo khác nhau. Mình cũng sẽ giải thích LoRA trong bối cảnh Stable Diffusion, những điều kiện cần khi dùng Shakker AI để train LoRA, và cuối cùng điểm qua chức năng chính của Stable Video Diffusion. Nếu bạn muốn hiểu sâu nhưng theo cách dễ nắm bắt, hãy cùng bắt đầu.
Stable Diffusion là một mô hình AI tạo sinh ra mắt năm 2022, giúp tạo hình ảnh từ mô tả bằng chữ. Thay vì vẽ tay, bạn chỉ cần gõ ý tưởng — phần mềm sẽ sinh nhiều biến thể ảnh phù hợp với mô tả, mở rộng khả năng sáng tạo cho cả người mới lẫn chuyên gia.
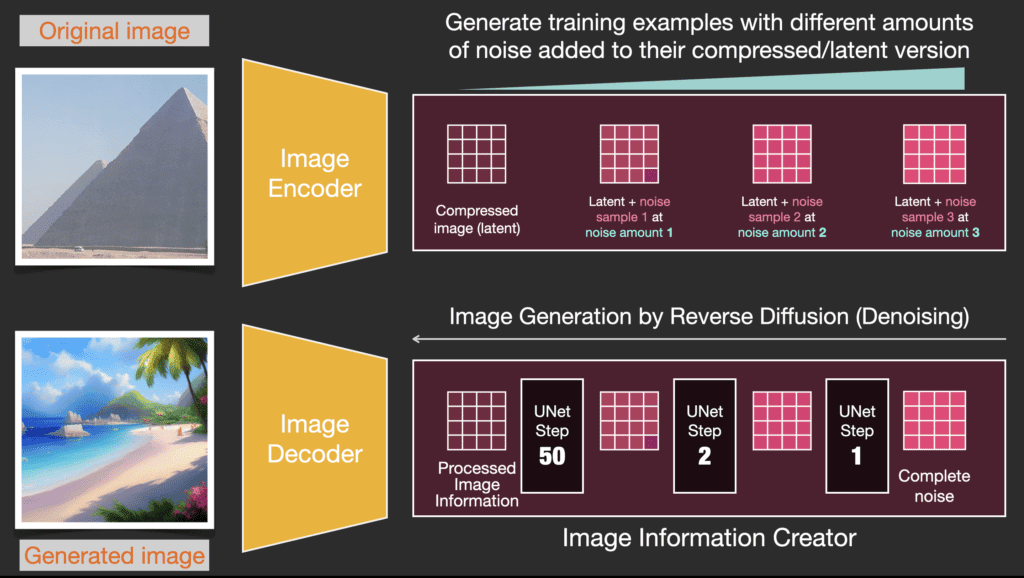
Nền tảng kỹ thuật của Stable Diffusion là mô hình khuếch tán, cụ thể là Latent Diffusion: mạng nơ-ron được huấn luyện trên hàng triệu cặp văn bản và hình ảnh. Khi sinh ảnh, mô hình bắt đầu từ một lớp nhiễu ngẫu nhiên rồi dần khử nhiễu theo hướng khớp với mô tả, tạo ra hình ảnh rõ.
Để chạy Stable Diffusion trên máy cá nhân, thường cần Windows 8/10/11 và một GPU có ít nhất 6GB VRAM (đa số GPU NVIDIA hiện đại đáp ứng). Cài đặt WebUI thường yêu cầu Git và vài bước tải mã nguồn. Dù vậy, phiên bản đám mây và giao diện thân thiện giúp mọi người dễ tiếp cận và khám phá khả năng sáng tạo của công cụ.

Diffusion Model là một loại mô hình tạo sinh, ý tưởng đơn giản nhưng mạnh: phá hủy cấu trúc dữ liệu một cách có hệ thống bằng cách thêm nhiễu dần dần qua nhiều bước — giống như thả mực vào nước cho đến khi dần hòa tan. Quá trình này gọi là khuếch tán thuận, làm cho dữ liệu trở thành nhiễu thuần túy từng chút một.
Phần trọng yếu là học cách đảo ngược quá trình đó. Mô hình được huấn luyện để dự đoán và loại bỏ nhiễu từng bước, từ trạng thái nhiễu hoàn toàn trở về dữ liệu gốc. Khi muốn sinh ảnh mới, ta bắt đầu từ nhiễu ngẫu nhiên và áp dụng chuỗi bước khử nhiễu đã học để tạo ra mẫu chất lượng cao.
So với những mô hình sinh khác như GAN, diffusion model thường ổn định khi huấn luyện và cho kết quả đa dạng, dù việc sinh mẫu có thể chậm hơn vì cần nhiều bước. Về cơ bản, thành phần chính là chuỗi khuếch tán thuận (thêm nhiễu) và chuỗi khuếch tán nghịch (khử nhiễu) do mạng học được, giúp biến nhiễu thành dữ liệu thực tế.

Điểm khác biệt chính giữa chế độ image2image và depth2image trong Stable Diffusion là nguồn hướng dẫn cho việc chỉnh sửa. Image2image dựa chủ yếu vào prompt (văn bản) và ảnh gốc để biến đổi phong cách, màu sắc hay chi tiết, còn depth2image dùng thêm bản đồ độ sâu (depth map) để kiểm soát cấu trúc không gian và hình học của cảnh.
Về cảm nhận khi dùng, image2img thường cho kết quả tự do hơn, dễ thay đổi bố cục và sáng tạo mạnh, nhưng cũng có thể làm méo hoặc thay đổi cấu trúc ban đầu. Ngược lại depth2img “ép” mô hình tuân theo độ sâu, giữ đường nét, tỷ lệ và quan hệ không gian tốt hơn — hữu ích khi cần nhất quán góc máy hoặc khi muốn tạo biến thể giữ nguyên khung cảnh cơ bản.
Thực tế là cả hai đều thuộc hệ sinh thái Stable Diffusion và có thể chạy trên máy cá nhân với GPU phù hợp. Chọn image2img khi cần sáng tạo, chọn depth2img khi ưu tiên chính xác về hình học; còn nếu cần, có thể kết hợp Depth Control (ví dụ via ControlNet) để đạt kiểm soát mạnh mẽ hơn.

Nếu quan tâm đến Stable Diffusion hay các model tạo ảnh, bạn hẳn không còn xa lạ với LoRA. LoRA (Low-Rank Adaptation) là kỹ thuật tinh chỉnh mô hình, cho phép bổ sung kiến thức vào mô hình lớn mà không phải huấn luyện lại toàn bộ, tiết kiệm thời gian và tài nguyên.
Bạn có thể coi LoRA như một “model con” nhỏ hơn checkpoint: nó tinh chỉnh các thành phần như Text Encoder và U-Net để thêm nhánh chủ đề hình ảnh đặc thù — ví dụ phong cách, nhân vật hay đồ vật. Vì kích thước nhỏ, LoRA dễ lưu trữ, chia sẻ và kết hợp với các checkpoint khác.
Cộng đồng thường up LoRA lên các trang như CivitAI để mọi người tìm, thử và kết hợp nhanh các bộ tinh chỉnh. Đây là công cụ hữu ích cho người muốn thử nghiệm phong cách mới mà không cần tải lại full model. LoRA đã trở thành phương pháp phổ biến cho việc tinh chỉnh Stable Diffusion.
Shakker AI là công cụ rất hữu ích để train LoRA, tạo ảnh và chỉnh sửa nhanh mà không cần quá rắc rối. Trước tiên bạn phải có tài khoản rồi chuẩn bị một bộ dataset gồm ảnh phù hợp — chất lượng tốt, đa góc độ nếu là khuôn mặt, và chắc chắn bạn có quyền sử dụng những ảnh đó.
Khi thực hiện trên giao diện Train LoRA, bước quan trọng là tải ảnh lên rồi chọn Re‑Crop/Tag để hệ thống tự động căn chỉnh và gắn thẻ; thao tác này giúp mô hình học đúng vùng cần tập trung. Ngoài ra nên chuẩn bị số lượng ảnh đủ lớn và nhất quán về phong cách để kết quả ổn định hơn.
Trước khi xuất bản, bạn cần cung cấp đầy đủ thông tin cho mô hình (tên, mô tả, tag liên quan) rồi nhấn “Tiếp theo” và “Xuất bản” để hoàn tất. Lưu ý kiểm tra lại quyền sử dụng ảnh, định dạng, và tag chính xác — những điều nhỏ này sẽ quyết định chất lượng LoRA khi deploy.

Stable Video Diffusion có chức năng chính là biến ý tưởng thành video ngắn hoặc chỉnh sửa đoạn phim từ văn bản và hình ảnh. Đây là mở rộng của Stable Diffusion (Image-to-Video) và dùng công nghệ khuếch tán cùng không gian ngầm để sinh khung hình liên tiếp với yêu cầu xử lý giảm, có thể chạy cục bộ.
Nó nổi bật ở khả năng duy trì tính nhất quán thời gian giữa các khung, chuyển từ text-to-image sang image-to-video, và hỗ trợ chỉnh sửa từng vùng bằng công cụ AI (ví dụ dùng cọ xóa để che và thay đổi vùng muốn sửa). Là mã nguồn mở, nên cộng đồng dễ tiếp cận và phát triển thêm tính năng.
Với Stable Video Diffusion, người làm sáng tạo có thể nhanh chóng thử nghiệm ý tưởng, cải thiện cảnh quay hoặc tạo minh họa động cho dự án mà không cần hạ tầng lớn. Mô hình còn “học” dần theo cách sử dụng, giúp kết quả ngày càng phù hợp với phong cách và yêu cầu của bạn.

Qua bài viết này bạn đã có cái nhìn tổng quan về Stable Diffusion và nguyên lý diffusion model, cùng sự khác biệt giữa chế độ Image2Image (chuyển đổi hình ảnh giữ phong cách) và Depth2Image (dùng bản đồ chiều sâu để giữ cấu trúc không gian). Bạn cũng biết LoRA là cách tinh chỉnh nhẹ mô hình, và khi dùng Shakker AI để train LoRA cần chuẩn bị dữ liệu sạch, cấu hình GPU đủ mạnh, thiết lập hyperparameter hợp lý và tôn trọng bản quyền dữ liệu. Cuối cùng, Stable Video Diffusion mở rộng sang tạo video mượt mà từ khung hình sinh bằng diffusion. Hãy thử nghiệm, học hỏi và luôn sáng tạo có trách nhiệm.